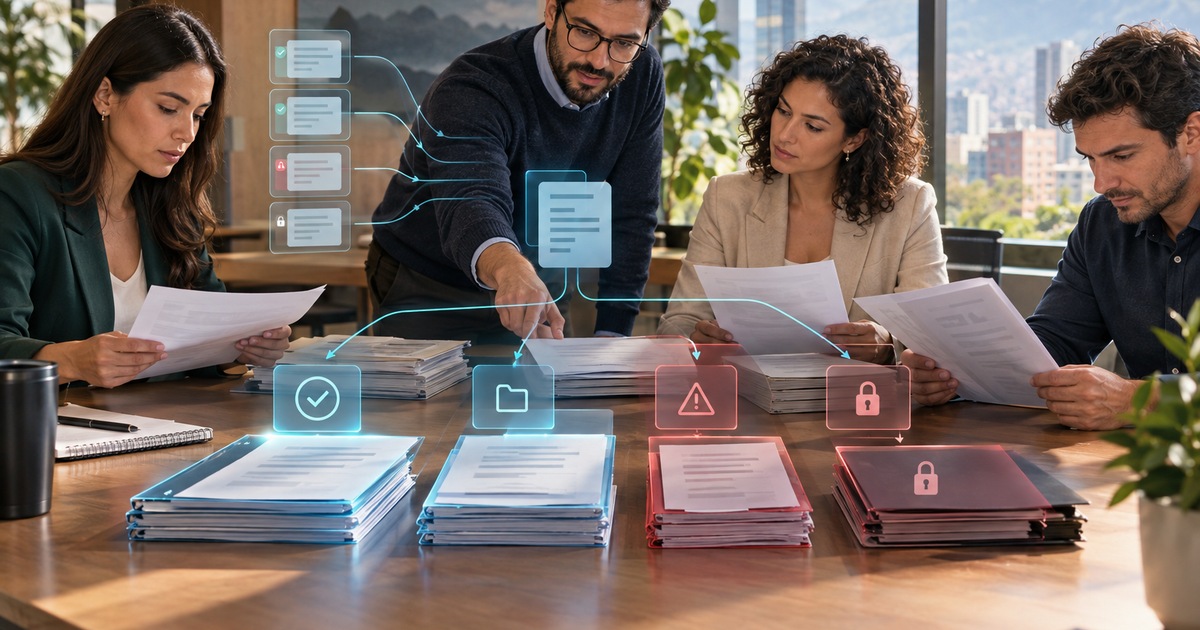
Una empresa decide ajustar un asistente con conversaciones históricas para que entienda mejor las preguntas de sus clientes. En la carpeta elegida aparecen contratos, firmas de correo, números de teléfono, reclamos, archivos enviados por error y documentos que ya no representan la política vigente.
La tentación es cargarlo todo y dejar que el modelo encuentre patrones. Esa decisión traslada al sistema una mezcla que la organización todavía no ha revisado. Después resulta difícil explicar de dónde salió una respuesta, retirar un dato específico o demostrar que el modelo dejó de usar una fuente que ya no debía estar allí.
Antes de hablar de entrenamiento, ajuste o mejora de respuestas, la dirección debería pedir una decisión más sencilla: qué información se conserva, para qué se conserva y qué debe retirarse.
El archivo útil no siempre es el archivo autorizado
Un documento puede ser valioso para entender un caso y aun así no estar autorizado para entrenar o ajustar una solución. Las conversaciones de soporte ayudan a mostrar preguntas frecuentes, pero también pueden contener nombres, direcciones, datos de acceso, información médica o comentarios hechos en confianza.
La utilidad operativa y la autorización son preguntas distintas. Para cada conjunto de datos conviene identificar al menos:
- de dónde proviene y quién lo recopiló;
- para qué propósito se obtuvo;
- qué información personal o confidencial contiene;
- qué versión o periodo representa;
- quién puede aprobar su uso;
- cuánto tiempo debe conservarse.
Si nadie puede responder esas preguntas, el conjunto todavía no está listo para entrar en una cadena de entrenamiento. Puede servir como material para una revisión controlada, pero no debería circular como fuente aprobada por defecto.
El marco de gobernanza de IA debe convertir estas decisiones en responsabilidades visibles. La persona que conoce el proceso puede explicar el valor del dato, pero no necesariamente tiene autoridad para autorizar su uso con otro propósito.
Conservar por una razón concreta
La pregunta “¿qué datos tenemos?” suele producir inventarios enormes. Para tomar una decisión útil hay que formular otra: “¿qué comportamiento queremos mejorar y qué evidencia hace falta para comprobarlo?”.
Si el objetivo es que un asistente clasifique solicitudes, quizá necesite ejemplos de categorías, mensajes representativos y el resultado validado por el equipo. No necesita conservar cada firma de correo ni todo el historial de la cuenta que envió la solicitud. Si el objetivo es reconocer documentos incompletos, hacen falta ejemplos de expedientes completos e incompletos, junto con el criterio que distingue ambos casos. Guardar documentos sin esa clasificación no crea una base de aprendizaje clara.
Una fuente merece conservarse cuando tiene un uso definido, un responsable y una forma de medir si realmente mejora el resultado. El resto debe quedar fuera del conjunto de entrenamiento, pasar a una zona de revisión o eliminarse según la política de la organización.
Esta disciplina también evita confundir entrenamiento con consulta. Un asistente puede necesitar consultar una fuente vigente para responder una pregunta sin incorporar todo su contenido de manera permanente al modelo. La arquitectura y los controles cambian según esa diferencia.
Qué conviene retirar antes de empezar
Hay datos que deben salir por razones de privacidad, seguridad, vigencia o calidad. Algunos ejemplos son:
- credenciales, tokens, llaves y enlaces con acceso;
- datos personales que no aportan al caso de uso;
- expedientes mezclados con información de terceros;
- documentos duplicados o con versiones contradictorias;
- pruebas internas, datos ficticios mal etiquetados y archivos enviados por error;
- políticas vencidas que compiten con la versión vigente;
- información cuya procedencia o permiso de uso no se puede demostrar.
Retirar no significa siempre borrar de inmediato todos los sistemas. La empresa debe distinguir entre excluir un archivo del conjunto de entrenamiento, eliminar una copia de trabajo, limitar un permiso, conservarlo por obligación legal o documentar una excepción. Cada acción tiene consecuencias distintas y debe quedar registrada.
En diciembre de 2024, el Comité Europeo de Protección de Datos explicó que los modelos de IA no deben considerarse anónimos automáticamente. Su análisis señala que la información personal puede permanecer representada en los parámetros y, en ciertos casos, ser obtenida mediante consultas. Para una empresa, esto vuelve insuficiente la explicación “el archivo original ya no está en la carpeta”. También hay que saber qué ocurrió con el modelo o ajuste que lo recibió.
La procedencia debe acompañar al dato
Una hoja de cálculo sin fecha puede parecer limpia y seguir siendo una mala fuente. Una política copiada a otra carpeta puede conservar el mismo texto, pero perder la relación con su dueño y con el proceso que la actualiza.
Cada conjunto usado para mejorar una IA debería llevar información que permita reconstruir su historia: fuente, fecha de corte, responsable, propósito autorizado, transformación aplicada, exclusiones y resultado de la revisión. El AI Risk Management Framework de NIST recomienda documentar el origen y la historia de los datos de entrenamiento como parte de la gestión de riesgos de IA generativa.
No hace falta convertir cada proyecto en un archivo burocrático. Sí hace falta que una persona pueda contestar, meses después, qué datos entraron, por qué se aceptaron, qué se retiró y qué versión del modelo o configuración se produjo.
Cuando la solución se conecta con la inteligencia artificial aplicada, esa trazabilidad debe llegar al uso cotidiano. Si una respuesta depende de una fuente externa o de un documento actualizado, el equipo debe poder diferenciar una consulta vigente de un conocimiento incorporado durante un ajuste anterior.
Los datos de entrenamiento necesitan fecha de salida
Una fuente no se vuelve confiable por haber sido aprobada una vez. Cambian los precios, las políticas, los responsables, los requisitos y las condiciones de servicio. Si el conjunto de entrenamiento no tiene una fecha de revisión, la organización puede seguir enseñando al sistema algo que ya dejó de ser cierto.
Conviene definir qué ocurre cuando una fuente vence. Algunas deben retirarse del conjunto y reemplazarse por una versión nueva. Otras pueden conservarse como evidencia histórica, pero no como instrucción operativa. En algunos casos habrá que volver a evaluar el modelo porque el dato retirado pudo influir en su comportamiento.
La automatización de procesos puede ayudar con alertas de vencimiento, tareas de revisión y registros de aprobación. No sustituye al responsable que decide si una fuente continúa representando la operación.
Una prueba de retiro vale más que una declaración
Decir que un dato fue retirado no demuestra que la solución haya dejado de usarlo. Una revisión razonable debería probar varios escenarios:
- preguntar por el contenido retirado de forma directa;
- formular una pregunta parecida que podría activar ese contenido;
- comprobar que la fuente vigente ocupa su lugar;
- revisar los registros, índices, exportaciones o copias que sigan conectados;
- confirmar qué respuesta produce el sistema cuando ya no tiene una fuente autorizada.
El resultado puede ser una respuesta de “no tengo una fuente vigente”, una solicitud de revisión humana o una consulta a la versión actual. Eso es preferible a entregar una respuesta antigua con tono de certeza.
También conviene probar que el retiro no haya dañado un caso que sí debía seguir funcionando. El control no consiste en vaciar la base, sino en mantener una frontera clara entre información útil, información permitida y decisiones que todavía requieren una persona.
La dirección debe pedir cinco respuestas
Antes de aprobar un proyecto que use datos internos para entrenar o ajustar una IA, la gerencia puede pedir respuestas concretas:
- ¿Qué comportamiento se quiere mejorar y cómo se medirá?
- ¿Qué fuentes entrarán y quién aprobó su propósito de uso?
- ¿Qué datos personales, secretos o versiones vencidas fueron excluidos?
- ¿Cómo se retira una fuente y qué se revisa después en el modelo o configuración?
- ¿Quién responde por la vigencia, los permisos y las excepciones?
Si el proveedor solo muestra una demostración y no puede responder estas preguntas, todavía no ha demostrado que la solución sea gobernable. La empresa puede comenzar con un conjunto pequeño, documentado y revisable, en lugar de entregar toda su historia operativa de una vez.
La mejora de una IA empresarial depende tanto de la selección de datos como del modelo elegido. Conservar menos información, con propósito y responsable claros, suele producir una base más fácil de revisar y una operación con menos puntos ciegos. La decisión correcta no es entrenar con todo lo que existe, sino saber qué debe permanecer disponible, qué debe quedar fuera y cómo demostrar la diferencia.
Fuentes consultadas
¡Gracias por tu opinión!
No se pudo registrar tu voto. Inténtalo de nuevo.
Datos para IA: quién responde por cada fuente
Cómo asignar responsables y vigencia a las fuentes que alimentan una solución de IA.
Privacidad en IA: reducir campos antes de integrar
Una revisión práctica para reducir exposición antes de conectar información a una solución de IA.
Seguridad y gobernanza de IA
Permisos, datos, trazabilidad y revisión humana para operar IA con control.
¿Listo para aplicar esto en su operación?
Hagamos un diagnóstico inicial, sin compromiso.