Mantenimiento de agentes de IA: pruebas claveMaintenance of AI Agents: Key Tests
Un agente no se mantiene solo porque siga respondiendo. Se mantiene cuando alguien comprueba que todavía decide dentro de sus límites.An agent is not maintained just because it continues to respond. It is maintained when someone checks that it still decides within its limits.
El cambio pequeño que altera una respuesta crítica
Un agente puede funcionar bien durante semanas y fallar después de un cambio que parece menor: una versión nueva del modelo, una instrucción ajustada, una fuente de conocimiento actualizada, un permiso agregado o una integración que ahora devuelve un campo distinto.
Ese es el punto incómodo del mantenimiento de agentes de IA. El sistema no necesariamente se cae. No siempre muestra un error visible. A veces responde con más seguridad, pero interpreta peor una excepción, ignora una regla comercial o deja pasar una acción que antes escalaba a una persona.
Por eso el mantenimiento no debería limitarse a revisar consumo, disponibilidad o costo por respuesta. En proyectos empresariales, un agente también necesita pruebas de comportamiento. Global Agenttic lo trata como parte de la operación de IA aplicada: si el agente ayuda a ventas, soporte, documentación o administración, cada cambio debe probarse contra casos que sí representan el trabajo real. Esa disciplina también pertenece a la gobernanza diaria del negocio.
La regresión no siempre rompe el sistema
En software tradicional, una regresión suele verse como algo que antes funcionaba y ahora falla. Con agentes de IA, la regresión puede ser más sutil. El agente contesta, pero cambia el tono de una promesa. Resume bien, pero omite una condición. Clasifica el caso correcto, pero lo envía a la cola equivocada. Pide menos datos de los necesarios porque el modelo nuevo parece más "capaz".
La prueba útil no pregunta si el agente responde. Pregunta si responde dentro del alcance autorizado.
Un caso de soporte puede servir para verlo. Antes del cambio, el agente detectaba reclamos de facturación y los escalaba con número de cliente, fecha, canal y evidencia. Después del cambio, empieza a ofrecer una explicación preliminar porque encontró una política parecida en la base de conocimiento. El cliente recibe una respuesta rápida, pero la empresa perdió control sobre un caso sensible.
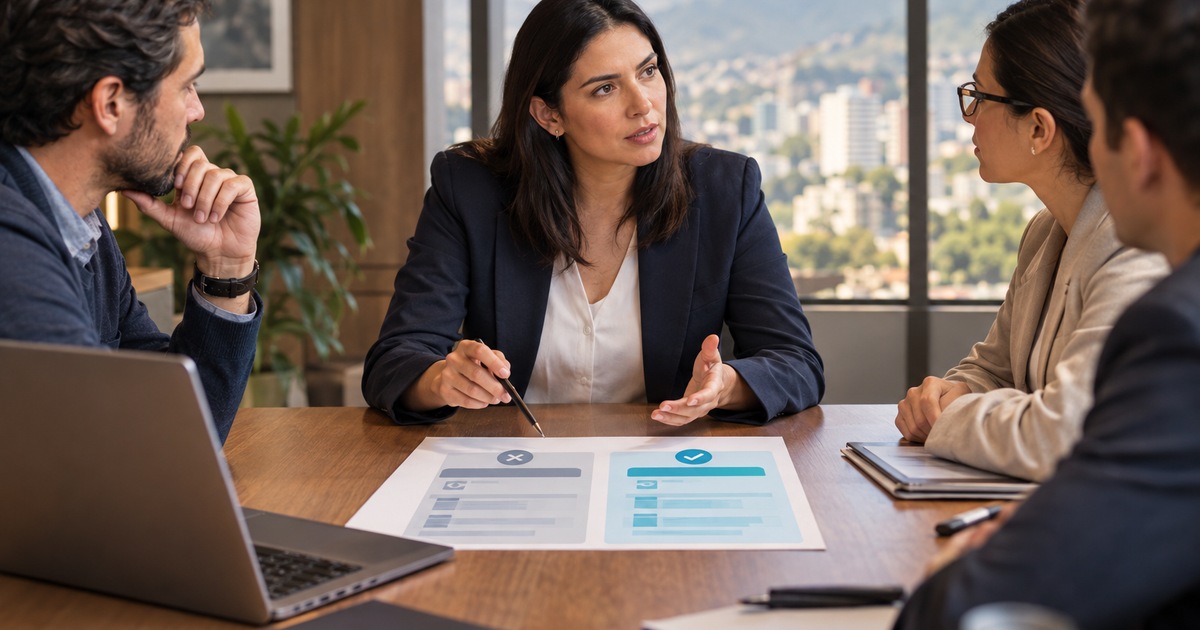
Ese tipo de desviación no aparece si la revisión se queda en métricas técnicas. Se detecta cuando alguien conserva una batería de casos de prueba con entradas reales, salidas esperadas y criterios claros sobre qué debe responder el agente, qué debe preparar y qué debe escalar.
Los casos de prueba deben parecerse a las excepciones
Un agente suele verse bien cuando se prueba con el caso ideal. El cliente pregunta algo directo, la base de conocimiento tiene una respuesta limpia y la acción no tiene consecuencia delicada. Eso sirve para una demo, pero no basta para mantenimiento.
La prueba mensual o posterior a un cambio debe incluir los casos torcidos: mensajes incompletos, datos contradictorios, solicitudes con urgencia falsa, clientes que mezclan dos temas, documentos vencidos, permisos insuficientes y preguntas donde la mejor respuesta es no responder todavía.
En una automatización conectada a CRM, por ejemplo, el agente no solo debe encontrar una oportunidad. Debe confirmar identidad, revisar si hay duplicados, distinguir entre contacto y empresa, y evitar actualizar una etapa comercial sin evidencia suficiente. Si el flujo también toca formularios, correo o tareas internas, conviene revisar esa cadena completa como parte de la automatización de procesos, no solo la conversación del agente.
La batería de pruebas debería guardar al menos cuatro tipos de casos: los que el agente puede resolver, los que debe preparar para revisión, los que debe rechazar por falta de autoridad y los que debe escalar con contexto. Sin esa separación, cualquier cambio puede empujar al agente a actuar de más o a volverse inútil por exceso de prudencia.
Permisos, fuentes y acciones se prueban juntos
Muchas empresas revisan el prompt cuando algo sale mal. A veces el problema está allí. Otras veces está en una fuente vencida, un permiso demasiado amplio, una integración que no distingue ambientes o una acción que no deja registro suficiente.
El mantenimiento de agentes de IA exige mirar esas piezas juntas. Si el agente consulta una base de conocimiento, hay que saber qué versión usó. Si recupera datos del CRM, hay que saber bajo qué rol lo hizo. Si propone una respuesta, debe quedar claro si solo redactó un borrador o si envió algo al cliente. Si actualiza un registro, la empresa necesita trazabilidad para revertir o explicar el cambio.
Esa revisión conecta directamente con seguridad y gobernanza de IA. No por formalidad, sino porque un agente empresarial trabaja cerca de datos, compromisos y decisiones. La gobernanza útil no vive en un documento aparte. Vive en permisos por tarea, fuentes con dueño, registros de acción y puntos de revisión humana que no dependen de la memoria del equipo.
La prueba debe ocurrir antes de producción, no después del susto
Cuando cambia el modelo, la tentación es soltarlo y observar. Para un asistente de uso interno con bajo riesgo, esa práctica puede ser aceptable si hay límites fuertes. Para un agente que responde clientes, modifica CRM, resume documentos sensibles o prepara decisiones comerciales, es una mala apuesta.
El cambio debería pasar primero por un ambiente controlado. Allí se ejecutan los casos guardados, se comparan salidas, se revisan excepciones y se decide si el agente puede volver a producción igual, con ajustes o con alguna acción deshabilitada temporalmente.
No hace falta convertirlo en una auditoría interminable. Una prueba breve, bien escogida, supera a cien preguntas improvisadas. Lo importante es que cada caso tenga una razón de existir: margen comercial, permiso, identidad, fuente vigente, tono autorizado, escalamiento o consecuencia operativa.
Si el agente falla en un caso crítico, no se arregla con confianza. Se reduce el alcance, se corrige la fuente o se devuelve esa parte del trabajo a revisión humana hasta que la prueba vuelva a pasar.
Costo por respuesta no mide mantenimiento
El costo por respuesta ayuda a controlar gasto, pero no dice si el agente sigue siendo seguro ni útil. Un agente barato que resuelve mal una excepción puede salir caro. Un agente más caro que escala con contexto y evita promesas indebidas puede proteger margen, reputación y tiempo del equipo.
Las métricas de mantenimiento deberían mirar calidad operativa. Por ejemplo: cuántas respuestas necesitaron corrección, cuántas excepciones fueron escaladas con información suficiente, cuántas acciones fueron revertidas, cuántos casos quedaron sin dueño y cuánto tardó el equipo en detectar una desviación después de un cambio.
También conviene revisar si el agente está aprendiendo mal de la operación. Si cada excepción termina como una regla nueva sin limpiar la causa, el sistema acumula parches. Si cada corrección humana se queda en la cabeza de una persona, el mantenimiento depende de quien estuvo ese día.
El objetivo no es que el agente parezca autónomo. Es que la empresa pueda confiar en lo que hace, entender por qué lo hizo y detenerlo cuando una condición cambió.
Una rutina razonable para sostener el agente
Una empresa no necesita un comité para cada ajuste menor, pero sí una rutina. Antes de cambiar modelo, prompt, fuente o integración, alguien debe registrar qué cambió y qué capacidad puede verse afectada. Después, se ejecutan los casos de prueba correspondientes y se deja evidencia de la decisión.
Si el cambio toca atención al cliente, se prueban reclamos, identidad y promesas. Si toca ventas, se prueban descuentos, cotizaciones, seguimiento y traspaso a CRM. Si toca documentación, se revisan versiones, vigencia y citas de fuente. Si toca operaciones internas, se prueban permisos, estados y escalamiento.
Esa rutina también ayuda a comprar mejor. Un proveedor serio de agentes no debería entregar una caja cerrada que nadie puede probar. Debe dejar criterios de aceptación, casos de regresión, registros de cambio y una forma clara de pausar funciones. Cuando Global Agenttic acompaña este tipo de implementación desde sus servicios digitales, la conversación comercial no termina en crear el agente. Incluye cómo sostenerlo cuando el negocio, los datos o el modelo cambian.
Soltar menos rápido puede ahorrar más tiempo
Un agente de IA vale cuando reduce carga sin sacar a la empresa de control. Para lograrlo, el mantenimiento debe probar comportamiento, no solo disponibilidad.
La pregunta práctica después de cada cambio es simple: si este agente cometiera hoy el mismo error que más daño nos haría, ¿lo detectaríamos antes de que llegue al cliente, al CRM o al proceso interno? Si la respuesta es no, el problema no es el modelo. Es la falta de una rutina de mantenimiento que trate al agente como parte de la operación real.
The Small Change That Alters a Critical Response
An agent can function well for weeks and fail after a change that seems minor: a new version of the model, an adjusted instruction, an updated knowledge source, an added permission, or an integration that now returns a different field.
That’s the uncomfortable point of maintaining AI agents. The system doesn’t necessarily crash. It doesn’t always show a visible error. Sometimes it responds with more confidence but misinterprets an exception, ignores a business rule, or lets an action pass that previously escalated to a person.
That’s why maintenance shouldn’t be limited to checking consumption, availability, or cost per response. In business projects, an agent also needs behavioral testing. Global Agenttic treats it as part of the applied AI operation: if the agent assists with sales, support, documentation, or administration, every change must be tested against cases that truly represent the real work. This discipline also belongs to the daily governance of the business.
Regression Doesn’t Always Break the System
In traditional software, regression is often seen as something that used to work and now fails. With AI agents, regression can be more subtle. The agent answers, but changes the tone of a promise. It summarizes well but omits a condition. It classifies the correct case but sends it to the wrong queue. It asks for fewer data than necessary because the new model seems more "capable".
The useful test doesn’t ask if the agent responds. It asks if it responds within the authorized scope.
A support case can serve to illustrate this. Before the change, the agent detected billing complaints and escalated them with customer number, date, channel, and evidence. After the change, it starts to offer a preliminary explanation because it found a similar policy in the knowledge base. The customer receives a quick response, but the company lost control over a sensitive case.
That type of deviation doesn’t appear if the review stays within technical metrics. It is detected when someone maintains a battery of test cases with real inputs, expected outputs, and clear criteria on what the agent should respond to, what it should prepare, and what it should escalate.
Test Cases Should Resemble Exceptions
An agent often looks good when tested with the ideal case. The customer asks something straightforward, the knowledge base has a clean answer, and the action has no delicate consequence. That’s useful for a demo, but it’s not enough for maintenance.
The monthly or post-change test should include twisted cases: incomplete messages, contradictory data, requests with false urgency, customers mixing two topics, expired documents, insufficient permissions, and questions where the best answer is to not respond yet.
In an automation connected to a CRM, for example, the agent must not only find an opportunity. It must confirm identity, check for duplicates, distinguish between contact and company, and avoid updating a sales stage without sufficient evidence. If the flow also touches forms, emails, or internal tasks, it’s advisable to review that entire chain as part of the process automation, not just the agent's conversation.
The battery of tests should include at least four types of cases: those the agent can resolve, those it must prepare for review, those it must reject due to lack of authority, and those it must escalate with context. Without that separation, any change can push the agent to act too much or become useless due to excessive caution.
Permissions, Sources, and Actions Are Tested Together
Many companies review the prompt when something goes wrong. Sometimes the problem is there. Other times it’s in an expired source, an overly broad permission, an integration that doesn’t distinguish environments, or an action that doesn’t leave sufficient records.
Maintaining AI agents requires looking at those pieces together. If the agent queries a knowledge base, it’s important to know which version it used. If it retrieves data from the CRM, it’s necessary to know under what role it did so. If it proposes a response, it must be clear whether it just drafted something or sent something to the customer. If it updates a record, the company needs traceability to revert or explain the change.
This review connects directly with AI security and governance. Not for formality, but because a business agent works closely with data, commitments, and decisions. Useful governance doesn’t live in a separate document. It lives in task permissions, sources with owners, action records, and points of human review that don’t rely on team memory.
Testing Should Occur Before Production, Not After the Scare
When the model changes, the temptation is to release it and observe. For an internal assistant with low risk, that practice may be acceptable if there are strong limits. For an agent that responds to customers, modifies CRM, summarizes sensitive documents, or prepares business decisions, it’s a bad bet.
The change should first go through a controlled environment. There, saved cases are executed, outputs are compared, exceptions are reviewed, and it’s decided whether the agent can return to production as is, with adjustments, or with some action temporarily disabled.
There’s no need to turn it into an endless audit. A brief, well-chosen test surpasses a hundred improvised questions. What’s important is that each case has a reason for existence: commercial margin, permission, identity, current source, authorized tone, escalation, or operational consequence.
If the agent fails in a critical case, it’s not fixed with confidence. The scope is reduced, the source is corrected, or that part of the work is returned to human review until the test passes again.
Cost Per Response Doesn’t Measure Maintenance
Cost per response helps control spending, but it doesn’t indicate whether the agent remains safe or useful. A cheap agent that poorly resolves an exception can end up being costly. A more expensive agent that escalates with context and avoids undue promises can protect margin, reputation, and team time.
Maintenance metrics should look at operational quality. For example: how many responses needed correction, how many exceptions were escalated with sufficient information, how many actions were reverted, how many cases were left without an owner, and how long it took the team to detect a deviation after a change.
It’s also advisable to review whether the agent is learning incorrectly from the operation. If each exception ends up as a new rule without cleaning the cause, the system accumulates patches. If each human correction stays in one person’s head, maintenance depends on who was there that day.
The goal is not for the agent to seem autonomous. It’s for the company to trust what it does, understand why it did it, and stop it when a condition changes.
A Reasonable Routine to Sustain the Agent
A company doesn’t need a committee for every minor adjustment, but it does need a routine. Before changing the model, prompt, source, or integration, someone should record what changed and what capability might be affected. Afterward, the corresponding test cases are executed, and evidence of the decision is left.
If the change touches customer service, billing, identity, and promises are tested. If it touches sales, discounts, quotes, follow-ups, and CRM transfers are tested. If it touches documentation, versions, validity, and source citations are reviewed. If it touches internal operations, permissions, states, and escalation are tested.
This routine also helps with better purchasing. A serious agent provider shouldn’t deliver a closed box that no one can test. They should provide acceptance criteria, regression cases, change records, and a clear way to pause functions. When Global Agenttic supports this type of implementation through its digital services, the commercial conversation doesn’t end with creating the agent. It includes how to sustain it when the business, data, or model changes.
Releasing Less Quickly Can Save More Time
An AI agent is valuable when it reduces workload without taking the company out of control. To achieve this, maintenance must test behavior, not just availability.
The practical question after each change is simple: if this agent were to make the same mistake today that would cause us the most damage, would we detect it before it reaches the customer, the CRM, or the internal process? If the answer is no, the problem isn’t the model. It’s the lack of a maintenance routine that treats the agent as part of the real operation.
¡Gracias por tu opinión!
No se pudo registrar tu voto. Inténtalo de nuevo.
Inteligencia artificial aplicadaApplied Artificial Intelligence
Agentes, asistentes y automatización con IA para procesos reales.Agents, assistants, and automation with AI for real processes.
Seguridad y gobernanza de IAAI Security and Governance
Permisos, trazabilidad, revisión humana y control operativo.Permissions, traceability, human review, and operational control.
Automatización de procesosProcess Automation
Flujos, integraciones y operación con menos trabajo manual.Workflows, integrations, and operations with less manual work.
¿Listo para aplicar esto en su operación?
Hagamos un diagnóstico inicial, sin compromiso.