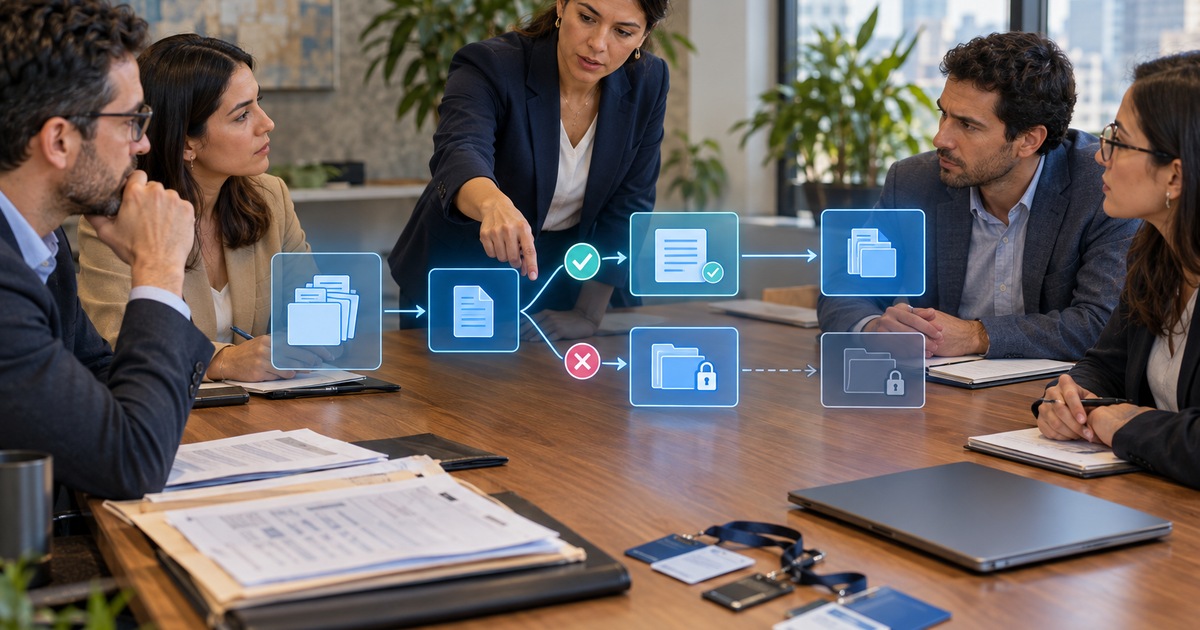
Una empresa conecta sus políticas, contratos, expedientes o historial de clientes a un modelo de IA. La explicación suele ser breve: "necesita contexto". Después aparecen preguntas que no estaban en el proyecto inicial. ¿El modelo solo consulta la información para responder? ¿La conserva? ¿Puede usarla para ajustar una solución? ¿Todos los usuarios pueden pedir lo mismo? ¿Quién puede demostrar qué ocurrió con esos datos?
El acceso y el uso son decisiones distintas. Una fuente puede estar disponible para preparar una respuesta concreta sin quedar autorizada para cualquier consulta, entrenamiento, exportación o acción posterior. Si la empresa no separa esas decisiones, termina con permisos amplios y poca capacidad para explicar el recorrido de su información.
La inteligencia artificial aplicada debe comenzar por esa diferencia. El modelo es una parte del sistema; el proceso, las fuentes, las personas autorizadas y la evidencia completan la solución.
Una conexión no define el propósito
Piense en un asistente que ayuda a un equipo comercial a encontrar condiciones de servicio. Puede consultar un catálogo aprobado y preparar una respuesta. Ese mismo acceso no debería permitirle revisar expedientes laborales, buscar información de otros clientes o enviar una cotización sin aprobación.
El problema aparece cuando el proyecto se describe como "conectar el repositorio" en lugar de expresar una capacidad. Consultar una política vigente, resumir un expediente autorizado y comparar dos versiones son tareas diferentes. Cada una puede necesitar fuentes, permisos, retención y revisión distintos.
Una definición más útil incluye el verbo y el límite: "consultar la política vigente para preparar un borrador dirigido a un usuario autorizado". Esa frase permite preguntar qué debe ver el modelo, qué queda fuera y qué persona aprueba la salida.
Acceso, consulta y uso posterior
Conviene distinguir al menos cuatro momentos del recorrido:
- Acceso: qué sistema, cuenta o integración puede leer una fuente.
- Consulta: qué fragmentos se recuperan para una solicitud concreta.
- Uso de la salida: quién puede ver, corregir, compartir o convertir la respuesta en trabajo.
- Uso posterior: si la entrada o la salida se guarda, se reutiliza para mejorar un sistema, se exporta o se incorpora a otro proceso.
Una empresa puede autorizar el primer momento y prohibir el cuarto. Por ejemplo, un asistente puede consultar documentos internos para responder durante una sesión, mientras la organización decide que esas conversaciones no se usarán para entrenar o ajustar otro modelo. Esa decisión debe quedar escrita en el contrato, la configuración y el procedimiento operativo que corresponda.
El AI Risk Management Framework de NIST plantea gestionar riesgos durante el diseño, desarrollo, uso y evaluación de los sistemas de IA. Su perfil para IA generativa identifica riesgos de privacidad relacionados con filtración, uso o divulgación no autorizada de información sensible y recomienda documentar el origen y el uso de los datos dentro del ciclo de vida.
El mismo dato cambia de riesgo según la tarea
Un número de cliente puede servir para localizar un caso en un sistema interno. Si aparece en una respuesta que se enviará por correo, el riesgo cambia. Una nota de soporte puede ayudar a clasificar una solicitud, pero ser inadecuada para elaborar un resumen visible para otra área. El documento no cambió; cambió el uso.
Por eso un inventario de datos no basta. Para cada tarea conviene indicar la fuente, los campos necesarios, la persona autorizada, la salida esperada y el destino de esa salida. Si un campo no modifica la decisión que se está probando, debe quedar fuera hasta que alguien justifique su inclusión.
La seguridad y gobernanza de IA debe cubrir el permiso de entrada y las consecuencias de la respuesta. Ocultar un dato en la pantalla no corrige que el modelo lo haya recibido. Tampoco resuelve el problema si la información termina en registros, archivos temporales o conversaciones disponibles para un grupo más amplio.
Entrenar, ajustar y consultar no son sinónimos
En conversaciones comerciales, "usar nuestros datos con IA" puede referirse a actividades muy distintas. Un sistema puede recuperar documentos pertinentes durante una consulta, ajustar un modelo con ejemplos propios o enviar datos a un proveedor para generar una respuesta. Cada alternativa tiene implicaciones diferentes de acceso, control, retención y salida.
La dirección no necesita elegir una modalidad por su nombre. Necesita pedir que el proveedor explique qué sucede con una entrada desde que sale de la organización hasta que llega la respuesta. También debe preguntar si la información se almacena, cuánto tiempo, quién puede acceder a ella, si se reutiliza para mejorar servicios y cómo se elimina o exporta al terminar la relación.
La respuesta debe corresponder al servicio contratado y a las condiciones vigentes. Si el proveedor no puede explicar el recorrido, la empresa todavía no tiene base suficiente para autorizar datos internos sensibles.
Panamá: finalidad y responsabilidad acompañan al dato
En Panamá, la Ley 81 de 2019 sobre protección de datos personales y el Decreto Ejecutivo 285 de 2021 forman parte del marco que debe considerar una organización que trata datos personales. La guía de ANTAI para el sector privado explica conceptos como datos personales, tratamiento y datos sensibles.
Para una implementación de IA, esto exige bajar la conversación a la operación. La empresa debe saber cuál es la finalidad de cada tratamiento, qué información cruza hacia el sistema, quién decide sobre ese tratamiento y qué ocurre si el dato debe corregirse, cancelarse o dejar de utilizarse. Este artículo no sustituye una revisión legal; señala preguntas que no deberían quedar escondidas detrás de la palabra "integración".
La prueba correcta separa lectura y acción
Un piloto puede comenzar con una fuente reducida y una tarea de consulta. Después debe probarse qué ocurre cuando el usuario pide algo fuera de su alcance, cuando el documento está vencido, cuando dos fuentes discrepan y cuando la respuesta se propone para una acción que requiere aprobación.
La automatización de procesos puede ayudar a crear vistas limitadas, registrar consultas, asignar excepciones y retirar accesos al terminar una prueba. El sistema aplica reglas; el dueño del proceso decide qué uso está autorizado y qué consecuencia requiere intervención humana.
Una prueba útil deja evidencia de la fuente consultada, la identidad o rol que inició la solicitud, la respuesta generada, la revisión realizada y cualquier acción posterior. Esa información permite corregir el diseño sin discutir solo sobre si la demostración "se sintió inteligente".
Preguntas que la dirección debe dejar respondidas
Antes de ampliar el acceso a datos internos, la dirección debería obtener respuestas concretas:
- ¿Qué tarea se quiere asistir y qué tareas quedan excluidas?
- ¿Qué fuentes puede consultar el modelo y con qué permiso?
- ¿Qué datos no necesita para cumplir el objetivo?
- ¿La consulta se almacena, se reutiliza o se usa para ajustar un modelo?
- ¿Quién puede ver la respuesta y quién puede convertirla en una acción?
- ¿Cómo se corrige una fuente, se revoca un acceso o se retira una copia?
- ¿Qué evidencia queda para revisar un incidente o una solicitud de datos?
Si las respuestas dependen de "la configuración estándar" del proveedor, todavía falta una decisión propia de la empresa. La tecnología puede ofrecer controles, pero la organización debe definir el propósito, el alcance y la autoridad.
El límite debe existir antes de conectar la fuente
Los modelos de IA pueden ayudar a leer, clasificar, comparar y preparar trabajo. Eso no convierte todo dato accesible en dato autorizado para cualquier uso. Separar acceso y uso permite comenzar con un caso acotado, medir el resultado y ampliar solo cuando la empresa entiende qué está entregando y qué conserva bajo su control.
Una implementación responsable no se reconoce por tener muchas fuentes conectadas. Se reconoce porque puede explicar por qué el modelo vio un dato, qué hizo con él y quién tenía autoridad sobre el siguiente paso.
Fuentes consultadas
¡Gracias por tu opinión!
No se pudo registrar tu voto. Inténtalo de nuevo.
Inteligencia artificial aplicada
Asistentes y agentes conectados con procesos, fuentes y límites operativos claros.
Seguridad y gobernanza de IA
Permisos, privacidad, trazabilidad y control para operar IA con responsabilidad.
Automatización de procesos
Flujos con responsables, reglas y revisión de excepciones.
¿Listo para aplicar esto en su operación?
Hagamos un diagnóstico inicial, sin compromiso.