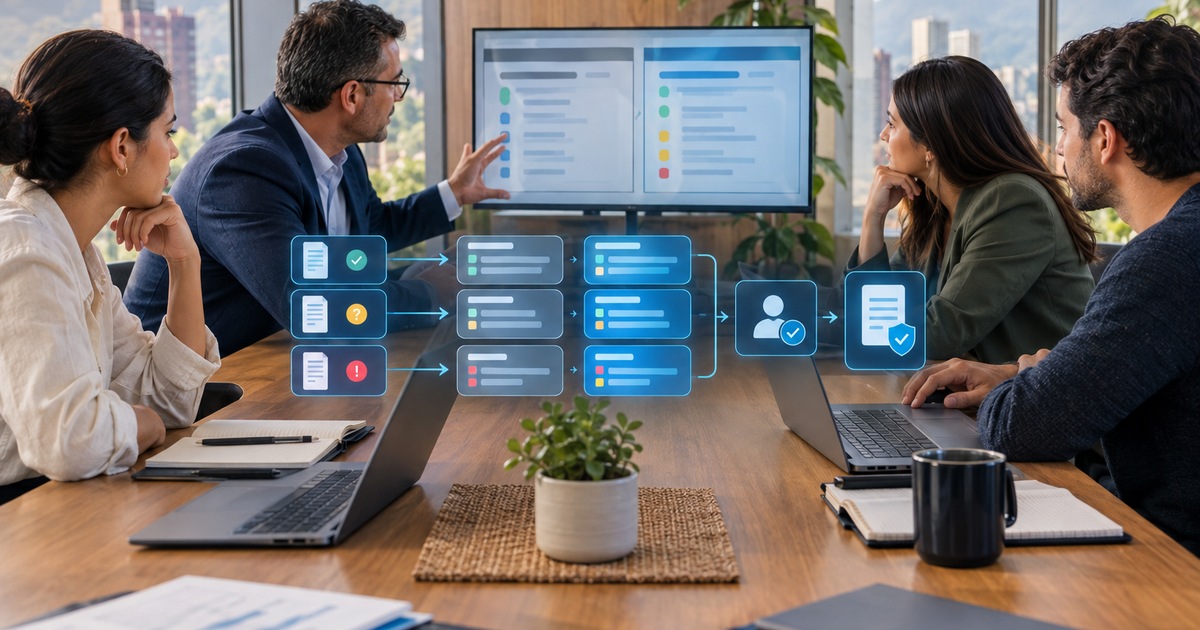
Un equipo cambia el modelo que resume solicitudes de clientes. La nueva versión responde más rápido y cuesta menos por consulta. En la demostración, todo parece igual: entra un mensaje, aparece un resumen y una persona revisa el resultado.
Días después, soporte descubre que algunos casos urgentes quedaron clasificados como consultas generales. Una respuesta que antes llegaba a la bandeja correcta ahora aparece en otra cola. Nadie apagó el sistema. El flujo siguió funcionando, pero empezó a llevar trabajo importante por una ruta distinta.
Ese es el riesgo de cambiar un modelo de IA dentro de una operación existente. La prueba no debe limitarse a comprobar si el sistema responde. Tiene que mostrar si sigue ayudando al proceso que la empresa necesita proteger.
El cambio de modelo también cambia el comportamiento
Un modelo puede producir respuestas distintas aunque reciba la misma instrucción y los mismos documentos. Puede resumir con otro nivel de detalle, interpretar de otra manera una frase ambigua, omitir un dato que antes incluía o sugerir una acción con más seguridad de la que corresponde.
El efecto depende del lugar que ocupa la IA. Un cambio en una herramienta que redacta borradores puede requerir revisión adicional. El mismo cambio en un flujo que clasifica reclamos, prioriza casos o prepara una actualización para clientes puede alterar tiempos, responsables y compromisos.
Antes de probar, la dirección debe identificar qué trabajo toca el modelo. Conviene registrar el flujo, la entrada, la salida esperada, el sistema que recibe el resultado y la persona que puede corregirlo. Sin ese mapa, la prueba termina midiendo una respuesta aislada y no la consecuencia que importa.
El AI Risk Management Framework de NIST plantea que la gestión del riesgo debe acompañar el diseño, desarrollo, uso y evaluación de los sistemas de IA. Aplicado a un cambio de modelo, significa comparar el comportamiento con el trabajo real y dejar claras las responsabilidades de supervisión.
Una muestra limpia puede ocultar el problema
Los casos fáciles suelen sobrevivir a casi cualquier cambio. Un mensaje bien escrito, con todos los datos y una sola intención, permite que dos modelos parezcan equivalentes.
La comparación debe incluir entradas que representen el trabajo diario: solicitudes incompletas, nombres parecidos, documentos contradictorios, cambios de última hora, lenguaje informal y casos que deben escalar. También debe incluir ejemplos donde la respuesta correcta sea pedir un dato, reconocer un límite o no ejecutar ninguna acción.
La empresa puede organizar la muestra por consecuencia. Los casos de bajo riesgo sirven para observar velocidad y formato. Los casos que afectan dinero, privacidad, compromisos comerciales o atención prioritaria necesitan criterios más estrictos y revisión de una persona que conozca el proceso.
Una respuesta no se evalúa solo por si suena bien. Hay que preguntar si conserva los datos que el equipo necesita, si cita la fuente correcta, si asigna la prioridad adecuada y si deja el caso en el estado que corresponde.
Hay que comparar el recorrido, no solo el texto
Dos modelos pueden producir resúmenes parecidos y, aun así, enviar los casos a áreas diferentes. Por eso la prueba debe seguir el resultado hasta el siguiente punto del flujo.
Si la IA clasifica correos, revise la bandeja que recibe cada categoría. Si prepara tareas, compruebe responsable, vencimiento y contexto. Si resume una conversación para ventas, confirme que el CRM conserva la oportunidad correcta y que el vendedor puede distinguir un hecho de una suposición.
La automatización de procesos ayuda a hacer visible ese recorrido. Un caso de prueba debería mostrar la entrada original, la salida del modelo, la regla aplicada, la acción posterior y la intervención humana. Esa evidencia permite saber si el cambio mejoró el trabajo o solo produjo una respuesta más agradable.
También conviene probar interrupciones. ¿Qué ocurre si el modelo no responde? ¿El caso queda detenido, vuelve a una regla anterior o pasa a una bandeja de revisión? Una operación estable necesita una salida conocida cuando el componente de IA falla o entrega un resultado que no cumple el umbral.
La calidad necesita criterios decididos antes
Si el equipo decide después de ver los resultados qué considera aceptable, es fácil ajustar la explicación hasta que el cambio parezca exitoso. Los criterios deben existir antes de comparar las versiones.
Pueden incluir exactitud de clasificación, conservación de datos relevantes, identificación de faltantes, tasa de escalamiento correcto, tiempo de revisión y cantidad de casos que requieren retrabajo. No todos los flujos necesitan las mismas medidas. Para un resumen interno puede importar la completitud. Para una respuesta al cliente también importan tono, fuente y límites de compromiso.
El umbral tampoco tiene que ser idéntico para todos los casos. Un error en una categoría de baja consecuencia puede corregirse durante la revisión. Un error que exponga información, confirme un precio equivocado o cierre un reclamo sin autoridad necesita una barrera más alta.
El perfil de IA generativa de NIST recomienda documentar límites de conocimiento, responsabilidades humanas, versiones de los modelos y mecanismos de evaluación. Para una empresa, eso se puede convertir en una ficha sencilla del cambio: qué versión se probó, con qué datos, bajo qué reglas, quién revisó y qué quedó fuera.
Un resultado mejor puede esconder un costo mayor
La calidad de la respuesta no es el único criterio. Un modelo puede mejorar la clasificación y aumentar el tiempo que necesita el equipo para revisar cada caso. También puede reducir el costo por consulta, pero generar más excepciones o más preguntas de los usuarios.
La comparación debe incluir el trabajo que aparece después. Mida cuántos casos llegan a la bandeja humana, cuánto tarda la corrección, cuántos registros deben rehacerse y si el equipo confía en el nuevo resultado. Cuando el modelo modifica un recorrido comercial, observe también si cambian los tiempos de respuesta, las oportunidades atendidas y los compromisos enviados.
La dirección necesita distinguir entre una mejora visible y una transferencia de trabajo. Si la IA produce un resumen más corto, pero el supervisor debe abrir tres sistemas para comprobarlo, el ahorro puede ser menor de lo que muestra la demo.
El cambio debe poder detenerse y explicarse
Una prueba responsable necesita una vía de regreso. Si el resultado del nuevo modelo altera una cola crítica o produce errores que el equipo no puede corregir a tiempo, debe existir una forma documentada de pausar el cambio y restablecer el comportamiento anterior.
Eso requiere conservar la versión previa, registrar cuándo se activó la nueva y definir quién tiene autoridad para suspenderla. También hace falta saber qué casos pasaron por cada versión. Sin esa trazabilidad, una investigación posterior puede encontrar el error, pero no reconstruir su alcance.
La seguridad y gobernanza de IA debe cubrir esa frontera, junto con accesos, fuentes, datos y responsabilidades. El equipo no necesita detener toda la operación ante cada resultado imperfecto. Sí necesita reconocer qué tipo de error obliga a intervenir y cuál puede corregirse dentro de la revisión normal.
El piloto debe parecerse al lunes, no a la presentación
Una prueba útil puede empezar con un solo proceso y un periodo limitado. El equipo compara el modelo actual y el nuevo sobre una muestra representativa, revisa los casos difíciles y observa qué ocurre después de cada salida.
Durante el piloto, incluya cambios de fuente, información faltante, usuarios con permisos distintos y solicitudes que no deberían resolverse automáticamente. Haga que una persona pueda señalar el error, corregir el resultado y dejar constancia de la causa. Si la corrección no llega al responsable del flujo, el piloto está midiendo una pantalla y no una mejora operativa.
Al terminar, la pregunta no es cuál modelo ganó en abstracto. Es si el cambio hizo más confiable el recorrido, qué condiciones necesita para mantenerse y qué riesgos siguen bajo responsabilidad humana. Con esa evidencia, la empresa puede ampliar, ajustar o descartar la modificación sin convertir una prueba incompleta en una dependencia permanente.
¡Gracias por tu opinión!
No se pudo registrar tu voto. Inténtalo de nuevo.
Mantenimiento de agentes de IA
Pruebas de regresión y control antes de devolver un agente a producción.
Seguridad y gobernanza de IA
Permisos, límites y trazabilidad para sistemas que apoyan la operación.
Automatización de procesos
Flujos con responsables, estados y excepciones visibles.
¿Listo para aplicar esto en su operación?
Hagamos un diagnóstico inicial, sin compromiso.